數據挖掘技術 從數據中萃取知識的藝術與科學
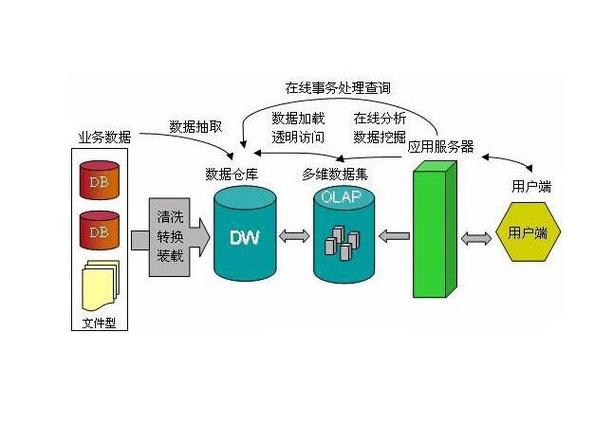
在信息爆炸的時代,我們被海量數據所包圍。從商業交易記錄、社交媒體互動到科學實驗觀測,數據正以前所未有的速度增長。數據本身并不等于價值,真正有價值的是蘊含在數據背后的模式、趨勢和知識。數據挖掘技術正是應此需求而生,它試圖從看似雜亂無章的數據中,挖掘出有用的信息和知識。
一、什么是數據挖掘?
數據挖掘(Data Mining)是指從大量、不完全、有噪聲、模糊、隨機的數據中,提取隱含在其中的、人們事先不知道但潛在有用的信息和知識的過程。它是一門交叉學科,融合了數據庫技術、統計學、機器學習、人工智能、模式識別等多個領域的理論和方法。
簡單來說,數據挖掘就是“從數據中挖掘知識”。它 Unlike 傳統的統計分析,更側重于自動發現未知模式,并處理大規模、高維度的數據。
二、數據挖掘的核心任務
數據挖掘的任務通常分為兩大類:描述性挖掘和預測性挖掘。
- 分類與回歸:分類用于預測離散類別標簽(如“是/否”,“高/中/低”),回歸用于預測連續數值(如房價、銷量)。常見算法包括決策樹、支持向量機、神經網絡等。
- 聚類分析:將相似的數據對象分組,使得同一組內對象相似度高,不同組間差異大。常用于客戶細分、圖像分割。
- 關聯規則挖掘:發現數據項之間的有趣關系,如“購買尿布的顧客往往也會購買啤酒”。經典算法為 Apriori 和 FP-Growth。
- 異常檢測:識別不符合一般行為模式的罕見事件,應用于欺詐檢測、故障診斷。
- 序列模式挖掘:發現隨時間變化的規律,如用戶購買序列、網頁點擊流。
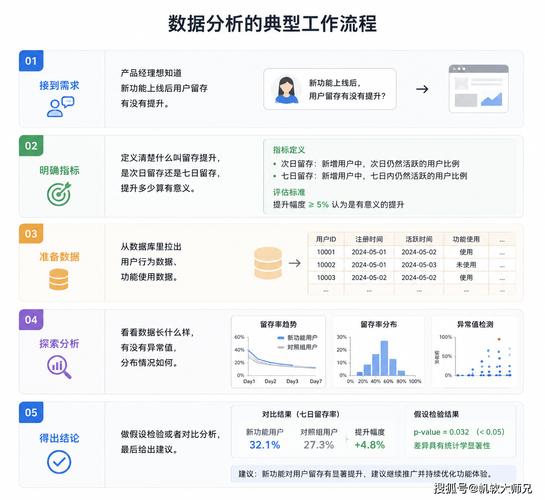
三、數據挖掘的典型流程
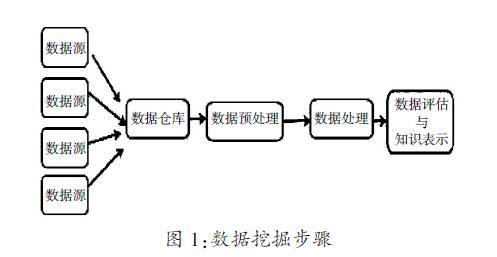
數據挖掘不是一個孤立的步驟,而是一個完整的知識發現過程(KDD),通常包括:
- 數據清洗:去除噪聲、處理缺失值、消除重復。
- 數據集成:將多源數據合并,解決語義模糊和沖突。
- 數據變換:歸一化、離散化、特征提取,使數據適合挖掘。
- 數據挖掘:應用算法提取模式。
- 模式評估:根據興趣度度量(如支持度、置信度、提升度)篩選有意義的模式。
- 知識表示:通過可視化、規則等方式呈現給用戶。
這個流程強調數據預處理往往占據整個項目70%以上的工作量。
四、常用工具與技術
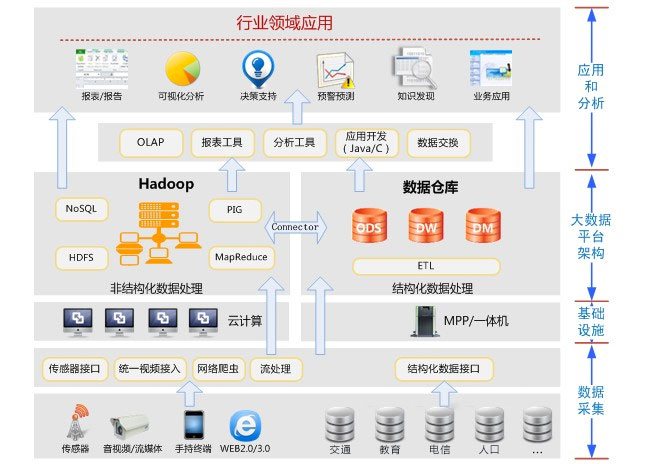
- 傳統工具:Weka、R、Python(scikit-learn、pandas、mlxtend)。
- 大數據平臺:Hadoop、Spark(MLlib)、Flink。
- 深度學習框架:TensorFlow、PyTorch,用于處理圖像、文本等非結構化數據。
- 商業智能工具:Tableau、Power BI 集成數據挖掘功能。
五、應用場景
- 零售業:購物籃分析、客戶忠誠度預測、商品推薦。
- 金融風控:信用評分、欺詐交易識別、反洗錢。
- 醫療健康:疾病預測、藥物反應分析、醫學影像診斷。
- 社交網絡:社區發現、意見領袖識別、輿情監控。
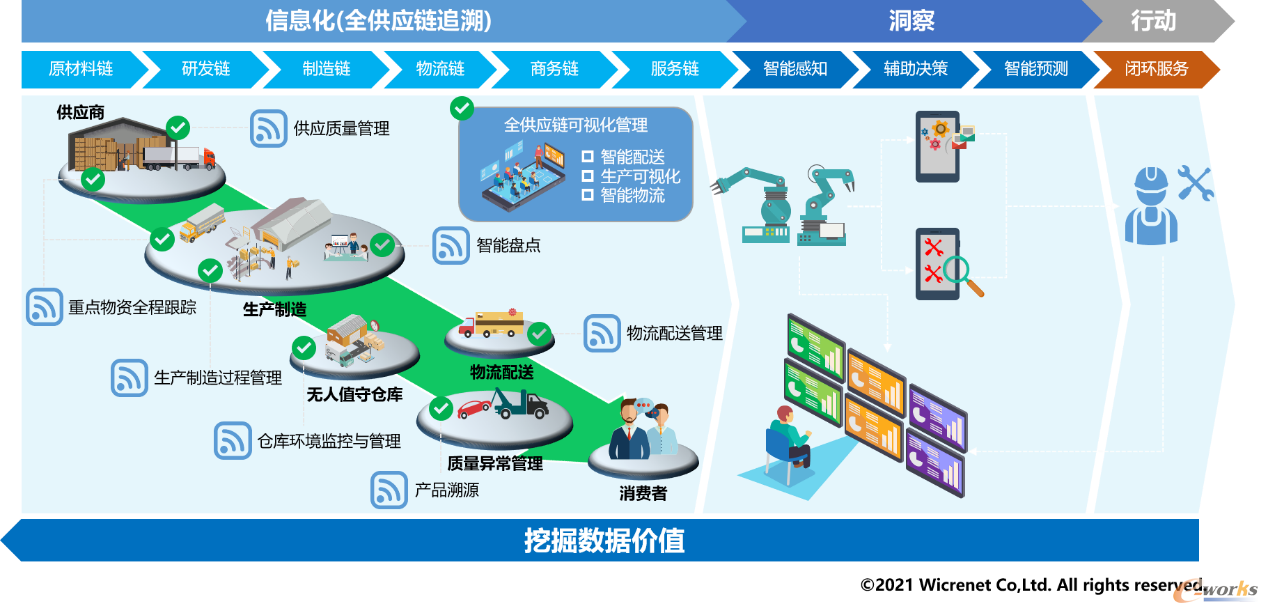
- 工業制造:設備故障預測、質量控制、供應鏈優化。
六、挑戰與未來趨勢
盡管數據挖掘技術取得了巨大成功,但仍面臨諸多挑戰:
- 數據隱私與安全:如何在挖掘價值的同時保護個人隱私,聯邦學習、差分隱私成為熱點。
- 數據質量:噪聲、缺失、不平衡數據影響模型效果。
- 可解釋性:深度學習模型常被視為“黑箱”,可解釋AI(XAI)日益重要。
- 實時性:流數據挖掘、在線學習需求增加。
- 自動化:AutoML 降低數據挖掘門檻,讓非專家也能構建模型。
數據挖掘將與云計算、物聯網、邊緣計算深度結合,實現更智能、更實時的知識發現。隨著生成式AI的興起,數據挖掘與生成模型的融合也將開辟新的可能性。
###
數據挖掘技術是連接數據與智慧的橋梁。它幫助我們從數據汪洋中捕撈知識之魚,為決策提供依據,為創新提供靈感。掌握數據挖掘,不僅是技術人員的技能,更是這個時代每個人理解世界的一種方式。隨著技術演進,數據挖掘必將在更多領域綻放光彩。
如若轉載,請注明出處:http://m.gooyaa.cn/product/40.html
更新時間:2026-10-24 08:39:21