《數據挖掘 第2版》書評 從特征分析到經典算法的系統指南
在數據科學領域,王朝霞教授所著的《數據挖掘 第2版》憑借其清晰的邏輯與扎實的內容,成為許多讀者入門與進階的重要參考。本書圍繞數據挖掘的核心流程展開,尤其注重數據特征分析及預處理、經典數據挖掘算法等關鍵環節,形成了一套從理論到實踐的知識體系。
一、數據特征分析及預處理:挖掘的基石
書中開篇即強調,現實世界的數據往往存在噪聲、缺失、不一致等問題。王朝霞教授系統介紹了數據特征分析的方法,包括數據的統計描述、可視化以及相似性度量。數據預處理部分涵蓋了數據清洗、集成、變換與規約等技術。這些內容不僅幫助讀者理解數據的內在結構,也為后續建模打下堅實基礎。例如,通過主成分分析(PCA)進行降維、利用分箱方法平滑噪聲,都是書中詳述的實用技巧。《數據挖掘 第2版》在此部分的講解兼顧原理與操作,使讀者能夠快速上手真實數據集。
二、經典數據挖掘算法:從分類到聚類
作為教材的核心,本書對經典數據挖掘算法進行了全面梳理。分類算法方面,涵蓋了決策樹(如ID3、C4.5)、樸素貝葉斯、K近鄰(KNN)、支持向量機(SVM)以及神經網絡等;聚類算法則包括K-means、層次聚類、DBSCAN等。王朝霞教授不僅闡述了每種算法的數學推導與流程,還對比了它們的優缺點和適用場景。例如,在講解決策樹時,書中詳細分析了信息增益、增益率與基尼指數的計算,并配有示例。關聯規則挖掘中的Apriori算法與FP-growth算法同樣得到深入剖析。這些經典算法是數據挖掘的根基,本書通過案例與習題幫助讀者融會貫通。
三、數據挖掘:完整流程與實戰視角
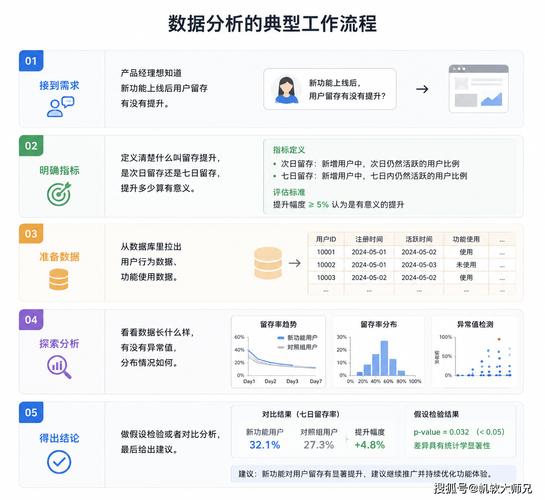
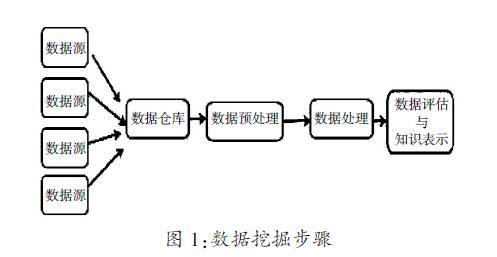
除了具體技術,本書還從系統角度介紹了數據挖掘的完整流程:問題定義、數據理解、數據準備、建模、評估與部署。這種CRISP-DM式的框架讓讀者跳出算法細節,把握整體項目邏輯。《數據挖掘 第2版》可能還涉及異常檢測、時間序列分析等擴展內容,并強調模型評估指標(如準確率、召回率、ROC曲線)的重要性。王朝霞教授在書中融入了多年教學與科研經驗,使得理論不枯燥,實踐有方向。
《數據挖掘 第2版》以數據特征分析及預處理為起點,以經典數據挖掘算法為骨架,構建了一幅清晰的知識地圖。無論你是計算機專業的學生,還是希望轉行數據科學的從業者,本書都能幫助你扎實掌握數據挖掘的核心技能。王朝霞教授的這本著作,值得放在案頭反復翻閱。
如若轉載,請注明出處:http://m.gooyaa.cn/product/46.html
更新時間:2026-10-24 07:37:16