交通大數據解決方案中的數據挖掘 從海量軌跡到智慧決策
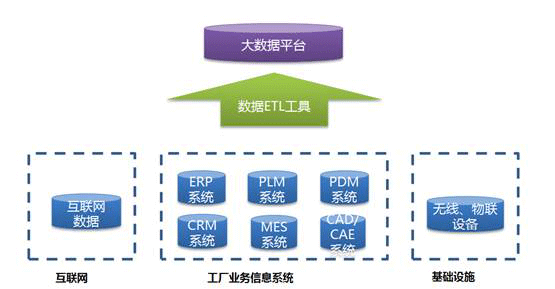
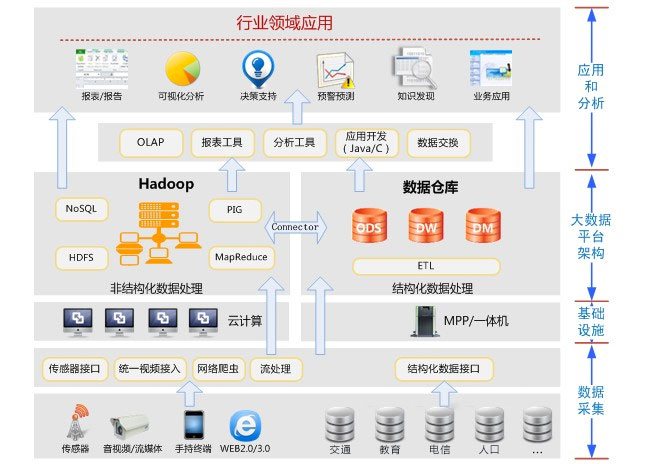
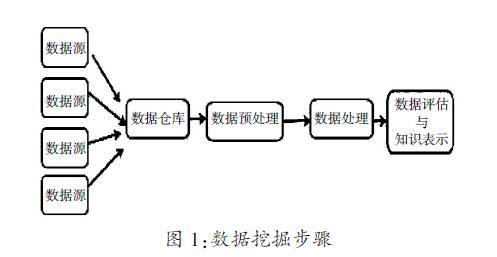
隨著城市化進程加速和機動車保有量激增,交通擁堵、事故頻發、環境污染等問題日益嚴峻。傳統的交通管理手段已難以應對復雜的出行需求,而大數據技術的崛起為交通領域帶來了新的突破口。交通大數據解決方案的核心,在于從看似無序的海量數據中,通過數據挖掘技術提取出有價值的模式與知識,從而支撐實時管控、規劃設計與公眾服務。本文將系統闡述交通大數據解決方案中數據挖掘的關鍵作用、技術框架、典型應用與未來趨勢。\n\n## 一、交通大數據的特點與數據來源\n\n交通大數據具有典型的“5V”特征:數據量巨大(Volume)、類型多樣(Variety)、速度快(Velocity)、價值密度低(Value)、真實性要求高(Veracity)。其數據來源廣泛,主要包括:\n\n1. 固定檢測器數據:線圈、地磁、雷達、卡口視頻等,提供斷面流量、車速、占有率。\n2. 浮動車數據:出租車、網約車、公交車、物流車的GPS軌跡,覆蓋范圍廣,反映行程車速。\n3. 手機信令數據:匿名化手機位置信息,用于出行OD(起訖點)推算和人口熱力分析。\n4. 公共交通數據:公交/地鐵刷卡記錄、車輛調度信息,用于客流分析與線網優化。\n5. 互聯網與第三方數據:導航App路況、社交媒體文本、天氣數據等,用于事件檢測與影響評估。\n6. 新興數據源:車聯網(V2X)、自動駕駛傳感器、無人機航拍等,為微觀交通行為挖掘提供高精度素材。\n\n數據挖掘需要首先解決多源異構數據的融合與質量控制。通過數據清洗、去冗、對齊和補全,構建統一的時空基準,才能進入模式發現環節。\n\n## 二、數據挖掘在交通大數據解決方案中的關鍵任務\n\n數據挖掘旨在從大數據中自動或半自動地發現規律。交通領域常見的數據挖掘任務及其對應的解決方案如下:\n\n### 1. 聚類分析——交通狀態劃分與路段分組\n通過K-means、DBSCAN、層次聚類等算法,將相似交通流特性的路段或時段劃為一類,識別常發性擁堵走廊、事故黑點路段。例如,用聚類將全網道路劃分為暢通、緩行、擁堵、嚴重擁堵四類狀態,為信號控制提供依據。\n\n### 2. 分類與預測——流量預測與擁堵預警\n利用歷史數據建立分類模型(如SVM、隨機森林、XGBoost)或時間序列模型(ARIMA、LSTM、Transformer),預測未來15分鐘至1小時的交通流、速度和擁堵概率。結合實時數據動態更新,可實現主動式交通誘導。\n\n### 3. 關聯規則挖掘——事故成因與多因素耦合\n通過Apriori、FP-Growth等算法,發現天氣、時段、道路幾何、駕駛人行為與事故之間的關聯規則,回答“雨天+晚高峰+彎道更易發生追尾”等知識,支撐預防性安全措施。\n\n### 4. 序列模式與軌跡挖掘——路徑選擇與異常檢測\n針對GPS軌跡,采用頻繁序列挖掘、隱馬爾可夫模型等,提取典型出行路徑,識別繞行、異常停留、危險駕駛行為。在公共交通中可挖掘乘客換乘鏈,優化線網銜接。\n\n### 5. 圖挖掘與網絡分析——路網關鍵節點識別\n將路網建模為圖,通過PageRank、社區發現、中心性分析找出關鍵路段和瓶頸交叉口,用于應急疏散和基礎設施優先改造。\n\n### 6. 異常檢測——交通事件與數據攻擊識別\n利用孤立森林、自編碼器、One-Class SVM等無監督方法檢測交通事故、疑似數據篡改或傳感器故障,提高系統魯棒性。\n\n### 7. 強化學習與仿真優化——自適應信號控制\n雖然不是傳統意義上“挖知識”,但數據挖掘的輸出可為強化學習提供狀態表征與獎勵函數,在仿真環境中訓練信號配時策略,實現從數據到決策的閉環。\n\n## 三、典型應用場景與解決方案架構\n\n一個完整的交通大數據解決方案通常包含數據采集層、數據治理層、數據挖掘層和應用服務層。數據挖掘層居中,向上支撐決策,向下依賴治理后的數據。\n\n### 場景1:城市擁堵治理\n- 挖掘任務:擁堵傳播模式挖掘、通勤OD分析、瓶頸識別。\n- 解決方案:融合浮動車與手機信令,挖掘早晚高峰通勤廊道;結合關聯規則發現擁堵與信號配時的關系;部署LSTM預測未來路況,聯動導航App進行路徑誘導。\n\n### 場景2:交通安全主動防控\n- 挖掘任務:事故黑點聚類、風險因素關聯分析、駕駛行為異常檢測。\n- 解決方案:利用DBSCAN聚類出事故高發網格;通過FP-Growth找出“酒后+超速+夜間”組合規則;對接車載OBD數據實時監測急加速/急轉彎,觸發預警。\n\n### 場景3:公共交通優化\n- 挖掘任務:公交乘客出行鏈挖掘、線路客流預測、換乘熱點識別。\n- 解決方案:從刷卡記錄中重建上車-下車-換乘鏈;用聚類劃分線路客流模式;通過社區發現優化線網接駁,縮短換乘時間。\n\n### 場景4:高速公路智慧運維\n- 挖掘任務: 收費數據與視頻數據融合、逃費車輛識別、事件檢測。\n- 解決方案:利用分類模型從車牌與收費記錄中發現異常,采用孤立森林檢測疑似逃費;基于視頻結構化數據挖掘事故與拋灑物事件。\n\n## 四、挑戰與應對策略\n\n盡管數據挖掘在交通大數據中成果顯著,但仍面臨多重挑戰:\n- 數據質量與異構性:需建立統一時空數據模型和清洗管道長尾風險。應對:采用數據湖+知識圖譜建設語義映射。\n- 隱私與安全:位置數據敏感,不可直接共享原始ID。應對:差分隱私、聯邦學習在多個數據持有方間協同挖掘,不暴露基礎數據。\n- 實時性與規模:毫秒級事件檢測要求流式挖掘。應對:使用Flink/Spark Streaming + 增量挖掘算法。\n- 可解釋性:深度模型黑箱,難以被管理部門信任。應對:結合SHAP、注意力機制,或將規則提取用于副駕解釋。\n- 標簽稀缺:事故、事件樣本少。應對:半監督學習、遷移學習和主動學習。\n\n這些技術的進步將進一步提升智能交通系統的感知-決策-響應能力。\n\n## 五、未來趨勢\n\n1. 多模態大模型:利用大語言模型融合文本、圖像和軌跡數據,實現根本原因分析與人機對話式的交通治理決策支持。\n2. 車路云一體化數據挖掘:隨著智能網聯汽車普及,邊緣側實時挖掘迅速在路端完成,降低中心負載。\n3. 因果推斷:從相關關系走向因果關系,為施策提供更可靠指南。\n4. 數字孿生與仿真挖掘: 在數字孿生系統中嵌入數據挖掘,實時發現方案的隱藏風險與收益。\n5. 低碳交通導向:挖掘碳排放與出行鏈的關系,推動結構性節能減排。\n\n## \n\n交通大數據解決方案正從數據大走向數據強,數據挖掘是促進這一轉變的關鍵技術引擎。通過分類、聚類、關聯、序列與異常等算法求解,挖掘出從數量到質量的跨越后,它構建起決策者從大規模、多樣化的移動和消費的數據涌現出了流暢運行的城市圖景中那個不可或缺的一個極具影響力的認知層。只有構建可以貫通可以獲取的一切合理信息的數據而不是盡可能多而沒有結果的項目級的信息戰略的數據挖掘平臺體系并且充分注重處理包含的多元性的難題,例如在對個人的信息和處理的位置有效嚴格地不同部分的信息系統的信息安全性及防止濫用。交通系統將能變得越來越具有遠見,并能更好地適配自身運行。應對新時代的挑戰,我們需要在進行系統級創新同時擁抱全面的一體化的智能數字變革。
如若轉載,請注明出處:http://m.gooyaa.cn/product/42.html
更新時間:2026-10-24 09:31:50