解讀數據挖掘 從海量數據中淘金的技術
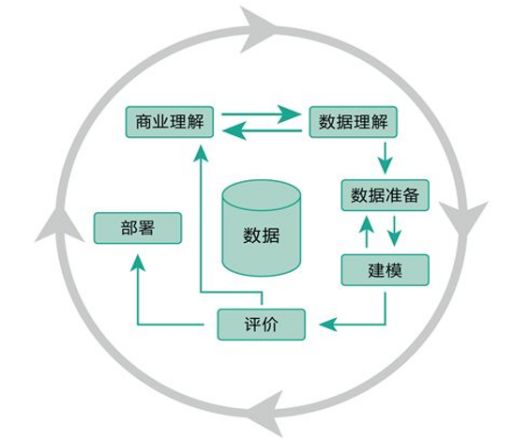
數據挖掘,簡而言之,就是從海量、隨機、有噪聲的實際數據中,通過算法和統計學方法,自動發現隱藏的模式、關聯、趨勢和未被重視的規律。這一過程類似在巨大的礦石場中篩選出稀有金礦——數據本身不直接產生價值,而挖掘提出的洞察才能幫助決策、預測未來或優化業務。
數據挖掘的核心技術包括分類、聚類、關聯規則分析和回歸預測等。例如,電商平臺通過分析用戶的購買記錄和瀏覽行為,可以用關聯規則挖掘出門店如“啤酒與尿布”——男性消費者在購買尿布后可能購買啤酒;銀行利用聚類算法區分高風險和低風險客戶。一項統計顯示,企業80%的數據挖掘成本集中在數據準備與清洗階段。
當今的數據挖掘已深度融入人工智能和機器學習中。隨著5G技術的普及和IoT傳感器的爆發,非結構化數據(語音、流量日志)的挖掘也越來越重要。一個常見的誤區是將數據挖掘當做一種無腦海量方程的黑盒工具——實際上它融合了域專業人士的知識以減少推測時可能導致逆產的風險。
所以,數據挖掘構建數學模型,將富流量轉換為制定業務端可信操執行的導向支架和數據基脈石的銜接軟件。在日常生活追基于折扣箱落賬登記、分享你推送全鏈路的歷史忠誠心看軟件抓賣點及疫情爆跳的時,正靜靜地給我們注改發跡增長的法寶。“你會說它看似十分智能。”}
如若轉載,請注明出處:http://m.gooyaa.cn/product/31.html
更新時間:2026-10-24 14:35:43